Domain bezeichnungen.de kaufen?
Wir ziehen mit dem Projekt
bezeichnungen.de um.
Sind Sie am Kauf der Domain
bezeichnungen.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain bezeichnungen.de kaufen?
Was sind die verschiedenen Methoden zur Klassifikation von Daten?
Die verschiedenen Methoden zur Klassifikation von Daten sind: Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Entscheidungsbäume teilen die Daten anhand von Merkmalen auf, künstliche neuronale Netze ahmen das menschliche Gehirn nach und Support Vector Machines finden die optimale Trennlinie zwischen den Datenpunkten. **
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik?
Die gängigsten Methoden zur Klassifikation von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu erkennen. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungelabelte Daten nutzt. **

Ähnliche Suchbegriffe für Daten
Top-Angebote
Produkte zum Begriff Daten:
-
Steganos Daten-Safe 2026Steganos Daten-Safe 2026 - Ihre Daten, Ihr Schutz Steganos Daten-Safe 2026 - Ihre Daten, Ihr Schutz Was ist Steganos Daten-Safe 2026 ? Steganos Daten-Safe 2026 ist die ultimative Lösung, um Ihre sensiblen Daten vor neugierigen Blicken und Cyberbedrohungen zu schützen. In einer zunehmend digitalen Welt, in der Datenschutz und Sicherheit von höchster Bedeutung sind, bietet dieser Daten-Safe die Gewissheit, dass Ihre persönlichen Informationen, Dokumente und vertraulichen Dateien sicher und geschützt sind. In dieser umfassenden Produktbeschreibung erfahren Sie alles über Steganos Daten-Safe 2026 , einschließlich seiner leistungsstarken Funktionen und Systemanforderungen. Leistungsstarke Funktionen von Steganos Daten-Safe 2026 1. Sichere Datenspeicherung Steganos Daten-Safe 2026 ermöglicht es Ihnen, vertrauliche Dateien in einem verschlüsselten Safe zu ...24,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Fischer, Tin: Linke Daten, Rechte DatenLinke Daten, Rechte Daten , Warum wir nur das sehen, was wir sehen wollen , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20220402, Produktform: Leinen, Autoren: Fischer, Tin, Seitenzahl/Blattzahl: 240, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Statistiken; Gefühlte Wahrheit; Wahrheit; Fake News; Gesundheit; Gesellschaft; Grüne; Umwelt; Klima; Wirtschaft; Geld; Politik; Mario Mensch; Wirtschaftsstatistik; Statistik; Einwanderung, Fachschema: Analyse / Datenanalyse~Datenanalyse~Migration (soziologisch)~Wanderung (soziologisch)~Zuwanderung~Forschung (wirtschafts-, sozialwissenschaftlich) / Sozialforschung~Sozialforschung~Empirische Sozialforschung~Sozialforschung / Empirische Sozialforschung~Umwelt / Politik, Wirtschaft, Planung~Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Datenanalyse, allgemein~Sozialforschung und -statistik~Grüne Politik / Ökopolitik / Umweltschutz~Ökonometrie und Wirtschaftsstatistik~Wahrscheinlichkeitsrechnung und Statistik, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Migration, Einwanderung und Auswanderung, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag GmbH, Länge: 215, Breite: 144, Höhe: 26, Gewicht: 402, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 267813525,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft?
Die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning unlabeled Daten verwendet, um Muster und Strukturen zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungabelte Daten nutzt, um Modelle zu verbessern. **
-
Was ist die Bedeutung von globaler Etikettierung bzw. globaler Kennzeichnung?
Die globale Etikettierung oder Kennzeichnung bezieht sich auf die Praxis, Produkte oder Dienstleistungen mit Informationen zu versehen, die weltweit verstanden werden können. Dies kann beispielsweise die Angabe von Produktzutaten, Warnhinweisen oder Herkunftsangaben umfassen. Die Bedeutung liegt darin, Verbrauchern weltweit eine einheitliche und verständliche Information zu bieten und ihnen die Möglichkeit zu geben, fundierte Entscheidungen zu treffen. **
-
Welche Daten müssen hier bei der legalen Identifikation eingetragen werden?
Bei der legalen Identifikation müssen in der Regel persönliche Daten wie Name, Geburtsdatum, Geschlecht und Adresse eingetragen werden. Je nach Kontext können auch weitere Informationen wie Ausweisnummer, Staatsangehörigkeit oder Kontaktdaten erforderlich sein. Es hängt von den spezifischen Anforderungen der jeweiligen rechtlichen Bestimmungen oder Verfahren ab. **
-
Was sind die gängigen Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigen Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Klassen oder Kategorien zu unterteilen und Muster zu erkennen. Sie werden häufig in der Informatik und Statistik eingesetzt, um Vorhersagen zu treffen oder Muster in den Daten zu identifizieren. **

Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigsten Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Kategorien oder Klassen zu unterteilen und Muster oder Trends zu identifizieren. Sie werden häufig in der Informatik und Statistik eingesetzt, um Prognosen zu treffen oder Erkenntnisse aus den Daten zu gewinnen. **
Ist "Aktivist" eine korrekte Bezeichnung oder eine falsche Benennung?
"Aktivist" ist eine korrekte Bezeichnung für eine Person, die sich aktiv für eine bestimmte Sache oder ein bestimmtes Anliegen einsetzt. Es ist keine falsche Benennung, solange sie angemessen und treffend verwendet wird. **
Top-Angebote
Produkte zum Begriff Daten:
-
Yarbo Ersatz Daten CenterBesonderheiten des Daten CentersLiefert präzise Navigationsdaten an den Yarbo Core Verbindung mit Ihrem Heimnetzwerk über Ethernet (30-m-Kabel im Lieferumfang enthalten) Ausgestattet mit RTK-, Bluetooth- und HaLow-WLAN-AntennenLieferumfang:1x Yarbo Ersatz Daten CenterInformationen und Downloads: Yarbo Schnellstartanleitung (engl.) Yarbo Produktvorstellung (engl.) Yarbo Bedienungsanleitung (engl.)...329,00 €*Versand: 159,00 €Sichere Weiterleitung zum Anbieter
-
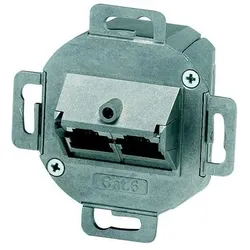
Mennekes Daten-Anschlussdose 41452Aufputzmontage=neinUnterputzmontage=neinKanaleinbau=neinBodentank/Unterflurmontage=neinBefestigungsart=schraubenZusammenstellung=Basiselement mit KomplettgehäuseSteckverbindertyp=2x RJ45 8(4)Mit Buchsen/Kupplungen=jaGeeignet für Anzahl Buchsen/Kupplungen=2Kategorie=6Farbe=sonstigeAnschlussart=LSABuchsen geschirmt=neinGehäuse geschirmt=neinSeparater Erdungsanschluss=neinMit Textfeld=jaDesignfähig=jaSeparate Kabelzugentlastung=jaMontageart Schirmanschluss=ohneAuslassrichtung=untenMit Staubschutz=neinMit Abschlusswiderstand=neinSchutzart (IP)=IP44Mechanische Codierung=neinFarbcodierung=neinGerätebreite=70 mmGerätehöhe=40 mmGerätetiefe=70 mm53,82 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Steganos Daten-Safe 2026Steganos Daten-Safe 2026 - Ihre Daten, Ihr Schutz Steganos Daten-Safe 2026 - Ihre Daten, Ihr Schutz Was ist Steganos Daten-Safe 2026 ? Steganos Daten-Safe 2026 ist die ultimative Lösung, um Ihre sensiblen Daten vor neugierigen Blicken und Cyberbedrohungen zu schützen. In einer zunehmend digitalen Welt, in der Datenschutz und Sicherheit von höchster Bedeutung sind, bietet dieser Daten-Safe die Gewissheit, dass Ihre persönlichen Informationen, Dokumente und vertraulichen Dateien sicher und geschützt sind. In dieser umfassenden Produktbeschreibung erfahren Sie alles über Steganos Daten-Safe 2026 , einschließlich seiner leistungsstarken Funktionen und Systemanforderungen. Leistungsstarke Funktionen von Steganos Daten-Safe 2026 1. Sichere Datenspeicherung Steganos Daten-Safe 2026 ermöglicht es Ihnen, vertrauliche Dateien in einem verschlüsselten Safe zu ...24,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die verschiedenen Methoden zur Klassifikation von Daten?
Die verschiedenen Methoden zur Klassifikation von Daten sind: Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Entscheidungsbäume teilen die Daten anhand von Merkmalen auf, künstliche neuronale Netze ahmen das menschliche Gehirn nach und Support Vector Machines finden die optimale Trennlinie zwischen den Datenpunkten. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik?
Die gängigsten Methoden zur Klassifikation von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu erkennen. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungelabelte Daten nutzt. **
-
Was sind die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft?
Die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning unlabeled Daten verwendet, um Muster und Strukturen zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungabelte Daten nutzt, um Modelle zu verbessern. **
-
Was ist die Bedeutung von globaler Etikettierung bzw. globaler Kennzeichnung?
Die globale Etikettierung oder Kennzeichnung bezieht sich auf die Praxis, Produkte oder Dienstleistungen mit Informationen zu versehen, die weltweit verstanden werden können. Dies kann beispielsweise die Angabe von Produktzutaten, Warnhinweisen oder Herkunftsangaben umfassen. Die Bedeutung liegt darin, Verbrauchern weltweit eine einheitliche und verständliche Information zu bieten und ihnen die Möglichkeit zu geben, fundierte Entscheidungen zu treffen. **
Ähnliche Suchbegriffe für Daten
-
Fischer, Tin: Linke Daten, Rechte DatenLinke Daten, Rechte Daten , Warum wir nur das sehen, was wir sehen wollen , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20220402, Produktform: Leinen, Autoren: Fischer, Tin, Seitenzahl/Blattzahl: 240, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Statistiken; Gefühlte Wahrheit; Wahrheit; Fake News; Gesundheit; Gesellschaft; Grüne; Umwelt; Klima; Wirtschaft; Geld; Politik; Mario Mensch; Wirtschaftsstatistik; Statistik; Einwanderung, Fachschema: Analyse / Datenanalyse~Datenanalyse~Migration (soziologisch)~Wanderung (soziologisch)~Zuwanderung~Forschung (wirtschafts-, sozialwissenschaftlich) / Sozialforschung~Sozialforschung~Empirische Sozialforschung~Sozialforschung / Empirische Sozialforschung~Umwelt / Politik, Wirtschaft, Planung~Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Datenanalyse, allgemein~Sozialforschung und -statistik~Grüne Politik / Ökopolitik / Umweltschutz~Ökonometrie und Wirtschaftsstatistik~Wahrscheinlichkeitsrechnung und Statistik, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Migration, Einwanderung und Auswanderung, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag GmbH, Länge: 215, Breite: 144, Höhe: 26, Gewicht: 402, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 267813525,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Daten-Spürnasen auf SpurensucheDaten-Spürnasen auf Spurensuche , Mit Spannung und Motivation in die Welt der Daten Haben Viertklässler mehr Spiele auf dem Smartphone als Drittklässler? Wie unterscheiden sich Mädchen und Jungen in ihren Hobbys? Brauchen Kinder aus einer Stadt wirklich länger zur Schule als Kinder aus einem Dorf? Daten-Spürnasen finden die Antworten! Bereits Grundschülerinnen und -schüler können in die Rolle von Daten-Spürnasen schlüpfen. Das zeigt dieses Buch. Die Kinder sammeln Daten, betrachten sie unter verschiedenen Perspektiven und finden die Informationen hinter den Daten. Dabei durchlaufen sie den kompletten Zyklus eines statistischen Projekts: von der Fragestellung über die Erhebung bis hin zur Auswertung. Der Einsatz digitaler Werkzeuge unterstützt die Schülerinnen und Schüler, auch umfangreiche Daten unter eigenen Fragestellungen zu untersuchen. An motivierenden und lebensnahen Themen eignen sie sich so nachhaltige Kompetenzen aus dem Inhaltsbereich "Daten, Häufigkeit, Wahrscheinlichkeit" an. "Daten-Spürnasen auf Spurensuche" gibt Orientierung und praxisnahe Anregungen durch: - erprobte Unterrichtssequenzen zur Datenanalyse - mit und ohne digitale Werkzeuge - von Klasse 2 bis 4, - zahlreiche Unterrichtsmaterialien (Arbeitsblätter, Datenkarten, Datensätze) im Buch und als Download, - didaktisch-methodische Informationen zur professionellen Vorbereitung und Durchführung des Unterrichts, - eine Einführung in die Datenanalyse mit der Software TinkerPlots Zielgruppe dieses Buchs sind interessierte Lehrkräfte für Mathematik und Sachunterricht an Grundschulen, Studierende und Referendare sowie Lehrerfortbildner*innen. , Zündspulen > Elektrik & Zündungen , Erscheinungsjahr: 20240821, Produktform: Kartoniert, Redaktion: Biehler, Rolf~Frischemeier, Daniel, Seitenzahl/Blattzahl: 221, Keyword: Daten; Häufigkeit; Wahrscheinlichkeit, Fachschema: Mathematik / Lehrermaterial~Mathematik / Statistik, Bildungsmedien Fächer: Mathematik, Algebra, Geometrie, Bildungszweck: für den Primarbereich~Für die Vorschule (Deutschland), Altersempfehlung / Lesealter: 23, Genaues Alter: GRS, Warengruppe: HC/Schulbücher/Unterrichtsmat./Lehrer, Fachkategorie: Unterricht und Didaktik: Mathematik, Schulform: GRS, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Kallmeyer'sche Verlags-, Verlag: Kallmeyer'sche Verlags-, Verlag: Kallmeyer'sche Verlagsbuchhandlung, Länge: 226, Breite: 162, Höhe: 15, Gewicht: 389, Produktform: Klappenbroschur, Genre: Schule und Lernen, Genre: Schule und Lernen, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Schulform: Grundschule, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, Unterkatalog: Schulbuch,29,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Welche Daten müssen hier bei der legalen Identifikation eingetragen werden?
Bei der legalen Identifikation müssen in der Regel persönliche Daten wie Name, Geburtsdatum, Geschlecht und Adresse eingetragen werden. Je nach Kontext können auch weitere Informationen wie Ausweisnummer, Staatsangehörigkeit oder Kontaktdaten erforderlich sein. Es hängt von den spezifischen Anforderungen der jeweiligen rechtlichen Bestimmungen oder Verfahren ab. **
-
Was sind die gängigen Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigen Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Klassen oder Kategorien zu unterteilen und Muster zu erkennen. Sie werden häufig in der Informatik und Statistik eingesetzt, um Vorhersagen zu treffen oder Muster in den Daten zu identifizieren. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigsten Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Kategorien oder Klassen zu unterteilen und Muster oder Trends zu identifizieren. Sie werden häufig in der Informatik und Statistik eingesetzt, um Prognosen zu treffen oder Erkenntnisse aus den Daten zu gewinnen. **
-
Ist "Aktivist" eine korrekte Bezeichnung oder eine falsche Benennung?
"Aktivist" ist eine korrekte Bezeichnung für eine Person, die sich aktiv für eine bestimmte Sache oder ein bestimmtes Anliegen einsetzt. Es ist keine falsche Benennung, solange sie angemessen und treffend verwendet wird. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.